بيانات جاهزة للذكاء الاصطناعي — كيف تحضر مجموعات بيانات نظيفة وآمنة للنماذج

بيانات جاهزة للذكاء الاصطناعي هي أحد عوامل النجاح الأساسية لأي مشروع يعتمد على النماذج، سواء للتدريب أو للاستدلال. هذه المقالة تشرح بخطوات عملية ما ينبغي فعله لتحضير مجموعات بيانات نظيفة، منظمة وآمنة يمكن أن تثبت قيمتها على المدى الطويل.
بيانات جاهزة للذكاء الاصطناعي
الهدف من تجهيز البيانات ليس الحصول على كمية كبيرة فحسب، بل على بيانات مناسبة وموثوقة تُحسّن أداء النموذج وتقلّل مخاطر التحيّز أو تسريب الخصوصية. سنغطي خطوات عملية، أدوات مقترحة ونصائح للحفظ والحوكمة.
لماذا تهتم بتحضير البيانات قبل التدريب؟
- تحسين جودة النماذج وتقليل الأخطاء الناتجة عن بيانات خاطئة أو مشوشة.
- تقليل تكلفة التدريب عبر استبعاد العينات غير المفيدة وتوفير وقت التجريب.
- الامتثال للخصوصية والقوانين وتقليل مخاطر تسريب معلومات حساسة.
- تمكين التكرار وإدارة الإصدارات لتتبع التغييرات وتحسين النماذج بمرور الزمن.
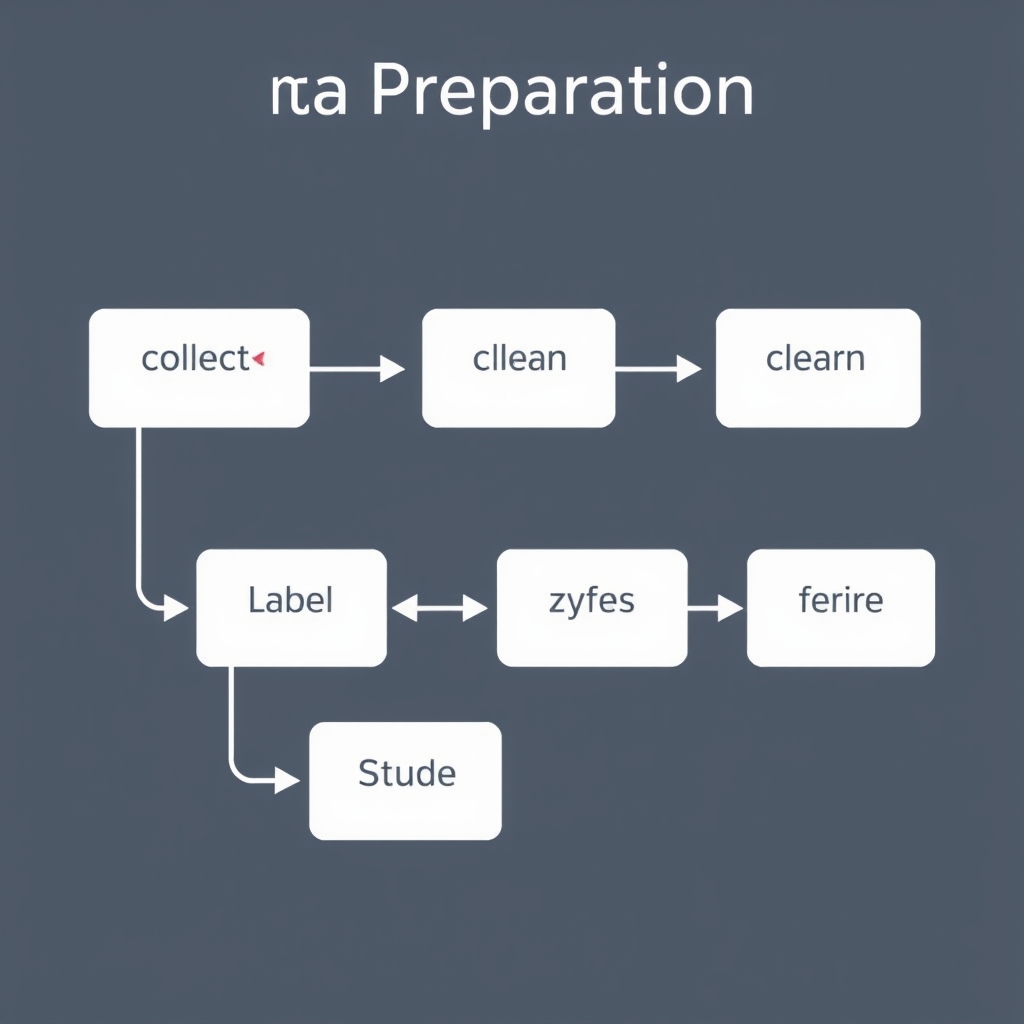
مراحل تجهيز البيانات خطوة بخطوة
فيما يلي خطوات عملية تُغطي المسار من جمع البيانات إلى تخزينها وإدارتها:
- حدد هدف النموذج ومعايير الجودة
- جمع البيانات المناسبة
- استخدم مصادر موثوقة: قواعد داخلية، واجهات برمجة التطبيقات، أو مجموعات بيانات مرخصة.
- تأكد من تنوع العينات لتقليل التحيز وتمثيل الحالات الحقيقية للمستخدم العربي عند الحاجة.
- تنظيم وتهيئة التنسيقات
- استخدم بنية ملفات قابلة للقراءة من قِبل خطوط إنتاج البيانات والأدوات الشائعة.
- تنظيف البيانات (Data Cleaning)
- أزل السجلات المكررة أو التالفة، صَحّح الأخطاء الواضحة، ولا تحذف بيانات مهمة بحماقة.
- طبق قواعد أساسية تلقائيًا ثم قم بمراجعة يدوية للعينات الحرجة.
- وسم البيانات وتوسيم الجودة (Labeling & QA)
- تقليل التحيّز والتحقق الإحصائي
- التعامل مع الخصوصية والحساسية
- اعمل على إزالة أو تعمية البيانات الشخصية قبل الاستخدام، واحتفظ بسجلات الإذن أو الترخيص.
- راجع سياسات مؤسستك، ويمكن الاطلاع على توجيهات حوكمة البيانات للذكاء الاصطناعي لمزيد من الإطار المؤسسي، مثل صفحة حول حوكمة البيانات.
- التخزين وإدارة الإصدارات
- اختبار سريع ونماذج صغيرة
أدوات وأساليب مفيدة
- تنسيقات ملفات: JSONL للنصوص، Parquet للبيانات الكبيرة والعمليات التحليلية.
- أدوات وسم: Label Studio، Supervisely، أو أدوات بسيطة مخصّصة حسب الحاجة.
- أدوات إدارة البيانات: DVC للنسخ والإصدارات، MLflow لتتبع التجارب، وأنظمة تخزين سحابي آمنة إذا دعت الحاجة.
للمزيد من المفاهيم العامة حول متطلبات البيانات للذكاء الاصطناعي يمكنك مراجعة تحليل خارجي موثوق يناقش هذه المتطلبات بشكل معمق.
من الناحية المؤسسية، ربط تجهيز البيانات بسياسة حوكمة يساعد على الامتثال وإدارة المخاطر؛ راجع مقالتنا عن كيفية بناء سياسة الذكاء السيادي وحوكمة البيانات لتفاصيل عملية ومفاهيمية. كما أن الاهتمام بخصوصية المحادثات والملفات عند استخدام خدمات الذكاء الاصطناعي يبقى جزءًا لا يتجزأ من التحضير؛ راجع نصائحنا لحماية خصوصية الذكاء الاصطناعي.
أسئلة شائعة
ما الفرق بين تنظيف البيانات وتنظيمها؟
التنظيف يركز على إزالة الأخطاء والمكررات وتصحيح القيم، بينما التنظيم يتعلق بتنسيق الملفات، تسمية الحقول، وبناء بنية تسهل الاستخدام عبر أدوات الخط إنتاج.
هل أحتاج إلى تصريح لاستخدام بيانات المستخدمين؟
نعم، إن كانت البيانات تحتوي معلومات شخصية أو تخضع لقانون محلي؛ احتفظ بسجلات الإذن وطبّق تعمية أو إزالة البيانات الحساسة عند الممكن.
ما أفضل تنسيق لبيانات النص لاستخدامها في نماذج اللغة؟
JSONL شائع لأنه يسمح بسطر لكل عينة مع الحقول الوصفية، ما يسهل المعالجة الدفعيّة والتكامل مع أدوات التدريب.
كيف أتعامل مع التحيز في البيانات؟
راجع التوزيعات الإحصائية، اجمع مزيدًا من العينات للفئات الناقصة، وطبق مراجعة بشرية على الحالات الحرجة. سجّل قرارات التصميم لتكون قابلة للمراجعة والتحسين.
خاتمة
تحضير بيانات جاهزة للذكاء الاصطناعي عملية متكررة تستفيد من تنظيم واضح، أدوات مناسبة، واهتمام بالخصوصية والحوكمة. البدء المنهجي بخطوات بسيطة وقياس النتائج على نماذج صغيرة يوفر وقتًا وجهدًا عند الانتقال لتدريب النماذج الكبيرة.
مصدر خارجي مفيد للقراءة التمهيدية: مقال تحليلي عن متطلبات البيانات للذكاء الاصطناعي.